
随着生成式人工智能的深度普及,如何创建 GPT 模型已经不再是少数顶尖算法科学家才能涉足的神秘领域。对于大多数普通用户和业务人员来说,利用 OpenAI 提供的零代码定制 GPTs 助手,就可以在短短几分钟内打造出符合特定场景的个性化工作伴侣;而对于有专业开发需求的程序员或是对底层技术感兴趣的爱好者,通过 Python 训练本地 GPT 神经网络,则是掌握 AI 底层逻辑、实现高度定制的终极路径。
在这篇文章中,我们将为您梳理两条完全不同的构建路线。无论您是想通过简单的对话快速生成一个属于自己的私人助理,还是希望敲下代码、从零搭建一个基于 Transformer 架构的语言模型,本文都将为您提供详尽的实操指南与原理解析。同时,我们也会探讨在企业级应用中如何进行云端部署,以及如何解决在创建过程中可能遇到的各类网络和权限问题。
路径一:零代码定制 GPTs 助手入门
对于大部分人来说,最快拥有专属 AI 模型的方法,就是使用 OpenAI 提供的 GPT Builder。这是一种完全不需要编写任何代码的图形化开发方式,能够让您通过像和朋友聊天一样的方式,定制出一个具备特定功能、语气和知识库的专属机器人。
第一步:在 ChatGPT 中启用 GPT 制作工具并设定初始角色
首先,您需要登录您的 ChatGPT 账号(确保您的账号已开通 Plus、Team 或 Enterprise 订阅权限)。在主界面的左侧边栏中,点击“Explore GPTs”按钮,进入 GPT 商店与管理页面。接着,点击右上角的“Create”按钮,系统会自动为您打开 GPT Builder 的工作区。
工作区分成左右两个部分:左侧是配置与对话区,包含“Create”和“Configure”两个标签页;右侧则是实时预览区(Preview),您可以在这里随时测试您刚刚做出来的模型表现。在“Create”标签页下,GPT Builder 会主动用英文或中文询问您:“你想制作一个什么样的助手?”
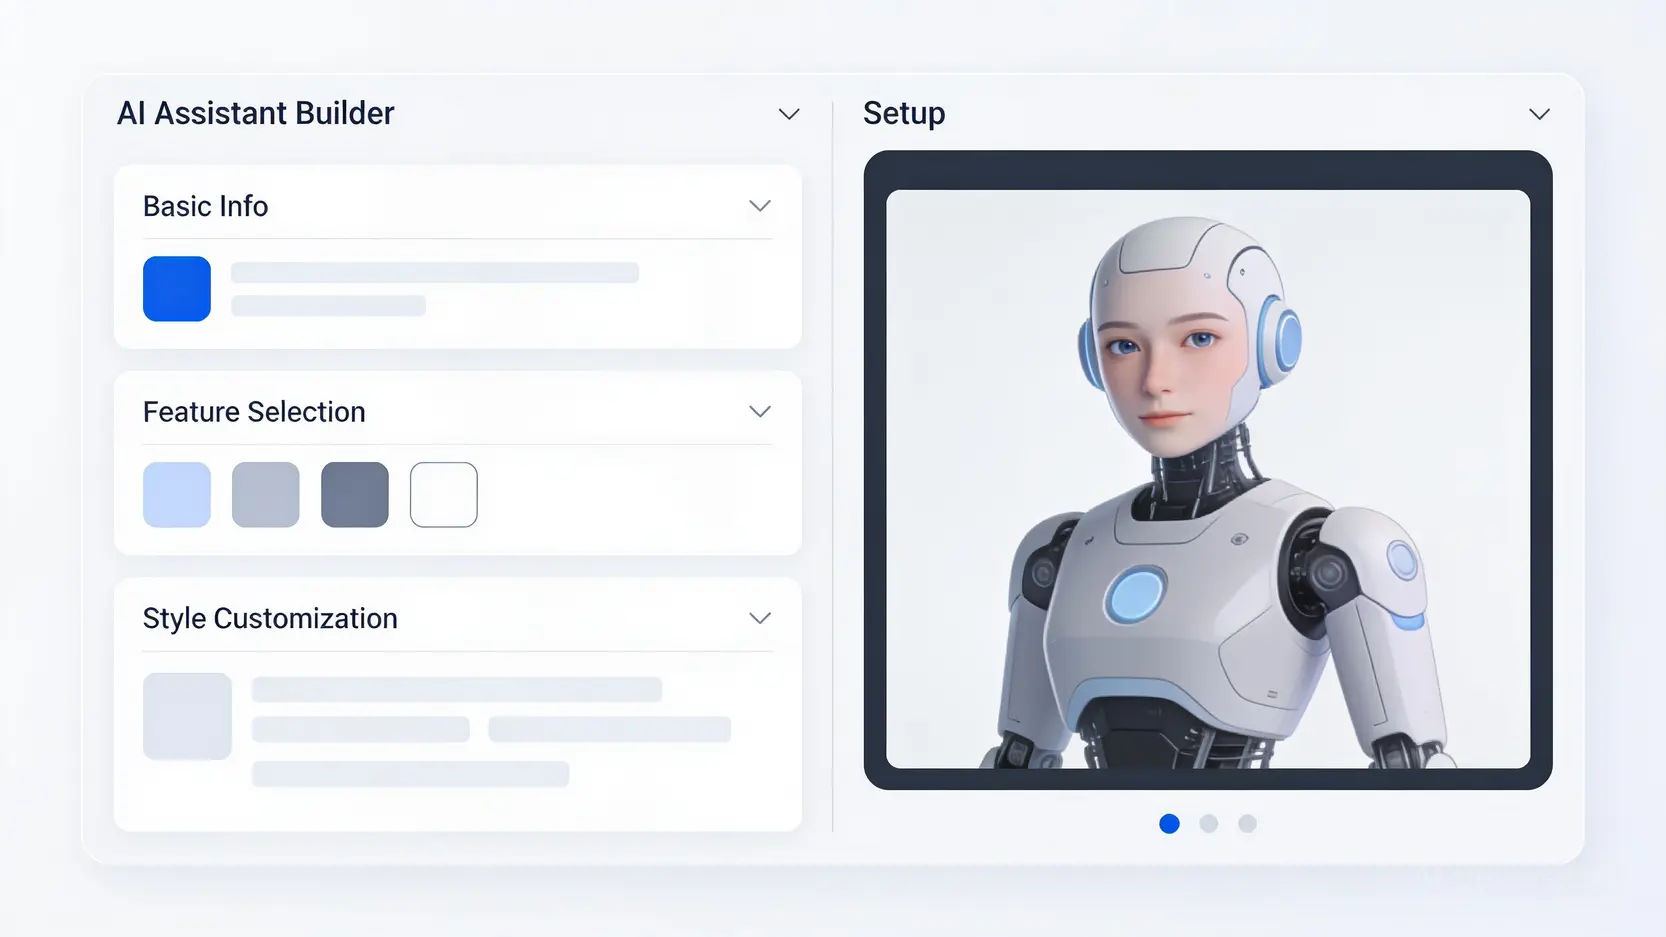
这时候,您只需要用大白话输入您的需求。比如:“我想创建一个专业的跨境电商文案写手,它需要精通英语、日语和德语,能够帮我把中文产品描述转化为符合当地消费者阅读习惯的推文。”收到指令后,GPT Builder 会自动为您起名字、生成头像,并初步设定好背后的系统提示词(Prompt)。
第二步:上传外部知识库与配置高级功能完成发布
虽然通过对话可以快速建立起一个雏形,但为了让这个专属助手表现得更专业,我们需要切换到“Configure”标签页进行精细化调整。在这里,您可以手动修改助手的名字、头像和详细描述,并进一步完善“Instructions”(即核心行为指令)。
最关键的部分在于上传外部知识库。默认的 GPT 只能回答它在公开训练数据中学到的通用内容,但如果您上传了公司的产品手册、特定行业的标准操作规程(SOP)或是您个人积累的素材库,这个助手就具备了“私有知识”。在“Knowledge”区域,点击“Upload files”,您可以上传 PDF、Word、Markdown 等格式的文件。系统会自动对这些文件进行分块和索引,在后续的对话中通过检索增强生成(RAG)技术来精准回答问题。
此外,您还可以在“Capabilities”中勾选是否让助手支持网页搜索(Web Browsing)、DALL-E 图像生成(DALL-E Image Generation)以及代码解释器(Code Interpreter)。如果您是进阶开发者,还可以在“Actions”中定义 OpenAPI 规范,让您的 GPT 能够调用外部的 API 接口,实现诸如查询天气、发送邮件或往您的数据库中写入数据等交互功能。确认无误后,点击右上角的“Publish”即可选择发布范围:仅自己可见、拥有链接者可见,或是公开到 GPT 商店。
路径二:使用 Python 训练本地 GPT 神经网络
如果您不满足于只在 OpenAI 的生态里做应用,而是希望从底层理解大语言模型的运转逻辑,那么通过 Python 训练本地 GPT 神经网络 是最直接的学习方案。在这一部分,我们将使用 PyTorch 框架,简要搭建一个基于 Transformer 架构的自回归语言模型。
基于 Transformer 架构编写 Bigram 语言模型核心代码与训练流程
在开始写代码前,我们需要了解 GPT 的本质:它是一个基于 Transformer 架构的 Decoder-only(自回归)模型,任务是通过前文预测下一个最可能出现的 Token(字或词)。为了让代码尽量简洁,我们先实现一个简化版的 Bigram 语言模型,并加入自注意力机制(Self-Attention)的结构。您可以参考 PyTorch Transformer 官方文档 以获取更底层的接口说明。
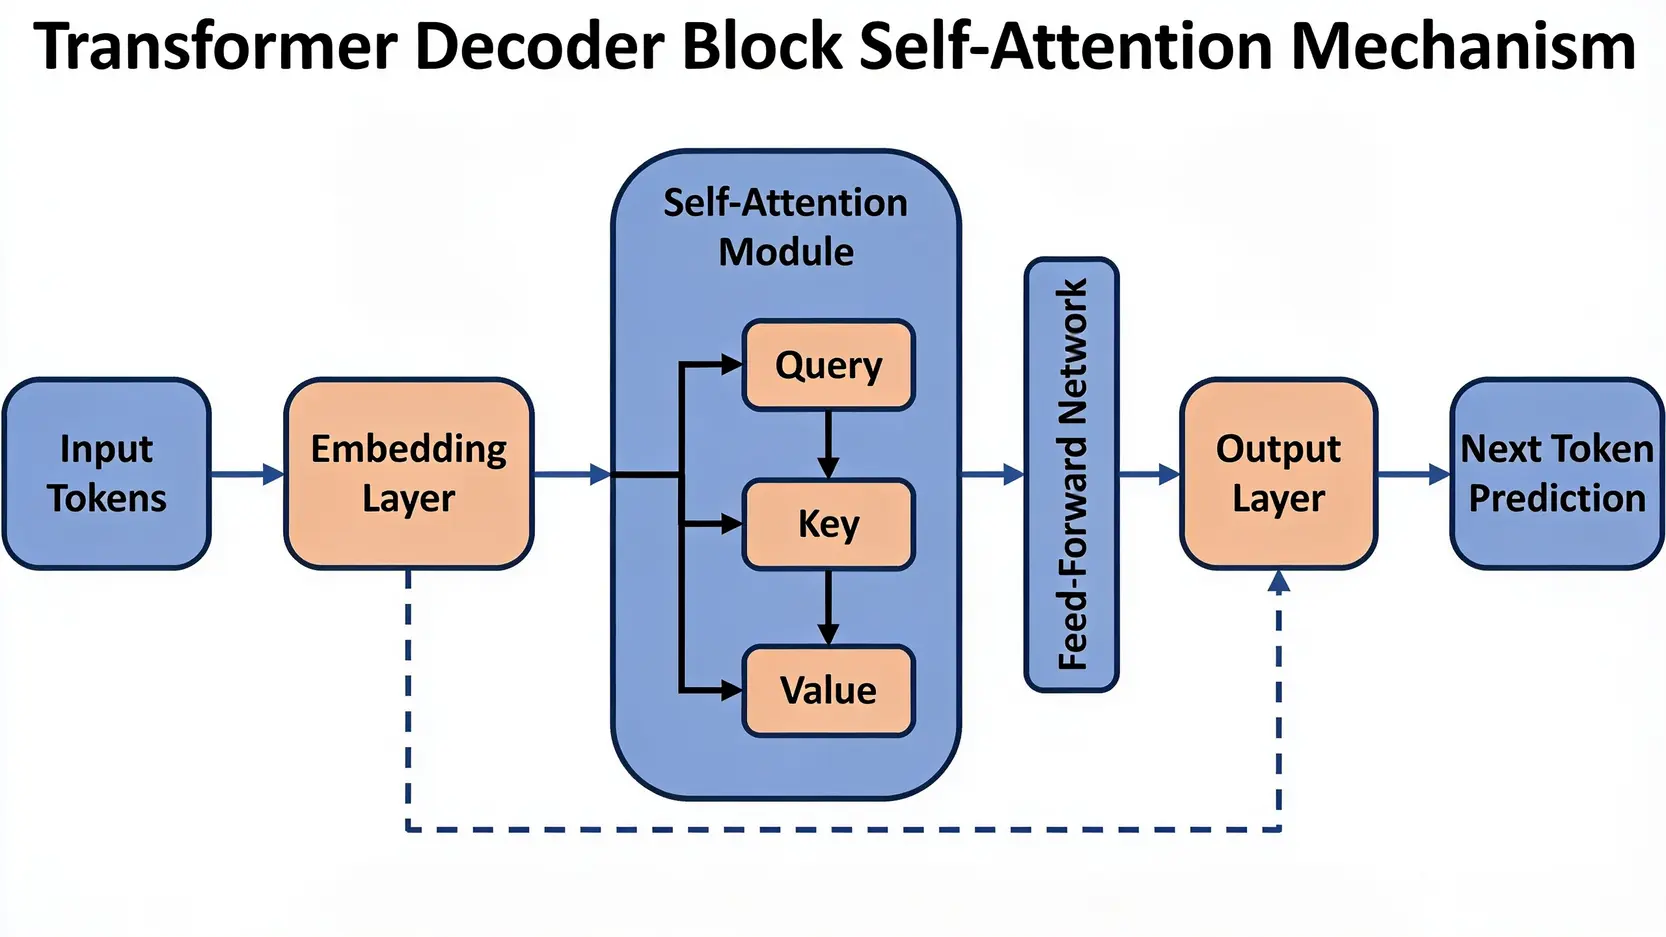
以下是使用 PyTorch 实现一个简单自注意力模块 and 模型基础架构的代码示例:
import torch
import torch.nn as nn
from torch.nn import functional as F

# 超参数设置
batch_size = 32
block_size = 8
max_iters = 3000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
n_embd = 32

# 简单自注意力机制单个头的实现
class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)   # (B, T, head_size)
        q = self.query(x) # (B, T, head_size)
        # 计算注意力权重 (Affinity)
        wei = q @ k.transpose(-2, -1) * (C**-0.5)
        # 因果遮罩(Mask),确保模型看不见未来的信息
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)
        # 执行加权聚合
        v = self.value(x) # (B, T, head_size)
        out = wei @ v     # (B, T, head_size)
        return out

# 简化的模型骨架
class SimpleGPT(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        # 每个 token 直接读取下一个 token 的 logits
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding_table = nn.Embedding(block_size, n_embd)
        self.sa_head = Head(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape
        tok_emb = self.token_embedding_table(idx) # (B, T, n_embd)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (T, n_embd)
        x = tok_emb + pos_emb # (B, T, n_embd)
        x = self.sa_head(x)   # (B, T, n_embd)
        logits = self.lm_head(x) # (B, T, vocab_size)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B*T, C)
            targets = targets.view(B*T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss
要在本地真正把这个模型跑起来,您需要准备一份训练语料(例如名著小说的文本文件),用 Python 将其读取并转换为字符集对应的数字索引(Tokenization)。接着,通过构建一个简单的循环训练(Training Loop),使用 AdamW 优化器不断反向传播更新参数,模型预测下一个字符的准确度就会逐步提升。通过了解如何用 PyTorch 制作 GPT,您能更深刻地明白什么叫上下文窗口、什么是 Temperature(温度系数),这对于您日后优化 Prompt 也有极大的帮助。
路径三:企业级方案:使用 Azure OpenAI 部署 GPT 实例
对于企业客户来说,出于数据安全、合规性以及高并发高可用性的考量,通常不会直接使用消费级的 ChatGPT Plus。很多企业会选择基于微软的云平台,利用 Azure OpenAI 部署 GPT 实例,因为微软承诺所有上传的数据均不会被用于公共模型的二次训练。
在 Azure AI Studio 中配置与管理专有部署
要在 Azure 上部署,首先需要申请企业资质以获取 Azure OpenAI 的使用特权。通过审核后,在 Azure Portal 中创建一个 Azure OpenAI 服务资源。接着,进入 Azure AI Studio 工作台。
在左侧导航栏的“Deployments”(部署)中,点击“Create new deployment”。您可以选择当前可用性极高的模型,例如 gpt-4o 或者是适合轻量任务的 gpt-3.5-turbo。为您的部署起一个唯一的名称(Deployment Name),这个名称将在您后续调用 API 时作为参数传入。在这里,您还可以设置每分钟令牌限制(TPM)上限,以防因流量暴增导致产生高昂的云端服务费用。
数据微调与 API 安全调用
虽然通过系统提示词(System Message)可以规范模型的行为,但当您需要模型极度模仿某种特定格式,或者必须遵循非常严格的行业术语规范时,数据微调(Fine-Tuning)就是非常必要的手段。Azure OpenAI 提供了直观的微调界面,您只需要将准备好的 JSONL 格式的对话训练数据集上传,系统就会在后台利用云端算力为您训练一个专属的微调模型版本。
部署完成后,您可以在 AI Studio 的“Playground”中进行调测,也可以在右侧直接复制 Python、C# 或是 Curl 格式的调用代码。为了保障安全,所有的请求都需要在 Request Header 中携带您的 API Key,或者利用 Azure Active Directory 进行更安全的身份鉴权。通过这种方式部署的 GPT 实例,不仅拥有极高的稳定性,还能完美融入企业现有的权限和网络隔离体系中。
解决无法创建 GPT 模型的常见问题
在实际操作过程中,无论是零代码的 GPTs 制作,还是基于 API 的代码开发,用户常常会遇到一些让人头疼的报错和限制。下面我们针对最常见的几种情况给出排战和解决办法。
访问受限与页面重定向排查
很多国内用户在点击“Create a GPT”或者尝试访问 GPTs 商店时,会遇到页面无限刷新、直接重定向回到 ChatGPT 首页,或者是显示“Access Denied”的报错。这通常是由于您的网络代理节点不够干净,触发了 OpenAI 的安全风控机制,导致系统判断您的账号不符合当前服务的使用条件。
解决这类问题的关键在于:使用纯净的静态住宅 IP 节点;尝试在浏览器中开启“无痕模式”以避开之前积累的 Cookie 污染;或者彻底清除浏览器中关于 `openai.com` 的本地缓存(Local Storage)和 Cookie。此外,请务必确认您的账号确实拥有合法的 Plus 订阅,否则许多高级创作面板是无法正常渲染出来的。
API 报错与限流处理
在进行 Python 本地调用或多并发测试时,开发者经常会遇到 `429 Too Many Requests`(请求过于频繁)的报错。这是因为任何新建的 API 账户或 Azure 部署都有严格的限流控制(Rate Limit)。
要在代码端解决这个问题,我们需要引入指数退避重试算法(Exponential Backoff)。在 Python 中,您可以使用像 `tenacity` 这样的第三方库,在捕获到 429 或 503 错误时自动延迟几秒钟再重新发起请求。同时,在本地处理大规模数据时,尽量将并发的 Request 合理打散,或者在代码中加入主动延时,以维持在官方规定的 RPM(每分钟请求数)限制之内。
总结
构建专属的 AI 助手是一项系统性的工程。对于大多数希望快速提升工作效率的非技术人员来说,熟练掌握 零代码定制 GPTs 助手 的技巧——如何精准编写 Instructions、如何整理和清洗知识库文档,就已经足够解决 90% 的日常办公需求。而对于希望将 AI 深度融入自家产品线或是有严苛合规要求的研究者与企业而言,掌握基于 Python 训练本地 GPT 神经网络 的原理,并配合 Azure OpenAI 部署 GPT 实例 进行稳定输出,则是保持技术竞争力的关键所在。理清您自身的技术背景和应用场景,选择最适合自己的那条路径,开始您的 AI 创建之旅吧。
FAQ:关于如何创建 GPT 模型的常见疑问
为什么我无法在 ChatGPT 中创建自己的 GPT 模型(出现重定向)?
通常是因为您的网络节点触发了 OpenAI 的安全拦截,或者您的账号目前不具备 GPT Plus / Team 订阅权限。建议清除浏览器缓存,使用无痕模式重新登录,并确保节点 IP 干净且稳定。
创建专属 GPTs 是否需要付费,普通用户可以使用吗?
在目前的版本中,虽然免费版用户可以探索和使用别人创建好的公开 GPTs,但如果您想要自己“新建”和“配置”个性化的 GPT 实例,仍然需要订阅 ChatGPT Plus 或是企业级的 Team / Enterprise 方案。
从零训练一个本地 GPT 模型需要什么样的高端硬件配置?
如果您只是想跑一个用于学习目的、参数量在几百万级别的玩具模型(如 Bigram 架构),普通的家用电脑 CPU 或单张 RTX 4060 显卡就足够了。但如果要训练一个真正具备实用价值的本地大模型(数亿乃至数百亿参数),通常需要多张 NVIDIA A100/H100 级别的显卡并搭配海量显存。
我可以直接上传公司的保密文档给 GPTs 吗?安全吗?
如果您使用的是 OpenAI 的消费级 Plus 账号创建的 GPTs,尽管可以设置“仅自己可见”,但数据依然会传输到 OpenAI 的服务器。对于敏感的商业机密,建议使用 Azure OpenAI 部署专属实例,或是在本地离线运行私有化的开源模型(如 Llama 3),以确保数据百分之百不出网。