
在AI大模型百花齐放的今天,许多人在使用人工智能助手时,常常会好奇:GPT 4 有多少个参数?众所周知,OpenAI官方对其底层的技术细节始终闭口不谈。然而,通过多份权威研究报告的流出,GPT-4 真实参数量已被证实达到了惊人的1.8万亿。这一庞大体量并非传统的单体结构,而是得益于先进的混合专家模型架构,使得其在运行时能够灵活控制激活参数量。接下来,我们将用通俗直白的语言,带你彻底看懂这个大模型的底层架构秘密。
GPT-4真实参数量是多少?解密1.8万亿背后的技术数据
在人工智能领域,模型的“参数量”通常被看作是衡量其智能程度的重要指标。简单来说,参数就像是人类大脑中的神经突触,数量越多,模型能够储存的知识就越丰富,逻辑推理能力也就越强。
那么,备受瞩目的GPT-4到底有多大?在GPT-4发布之初,OpenAI对其架构细节采取了严格的保密措施。但纸终究包不住火,科技界很快通过各种渠道拼凑出了它的真实面貌。
SemiAnalysis的独家爆料与学术界的侧面印证
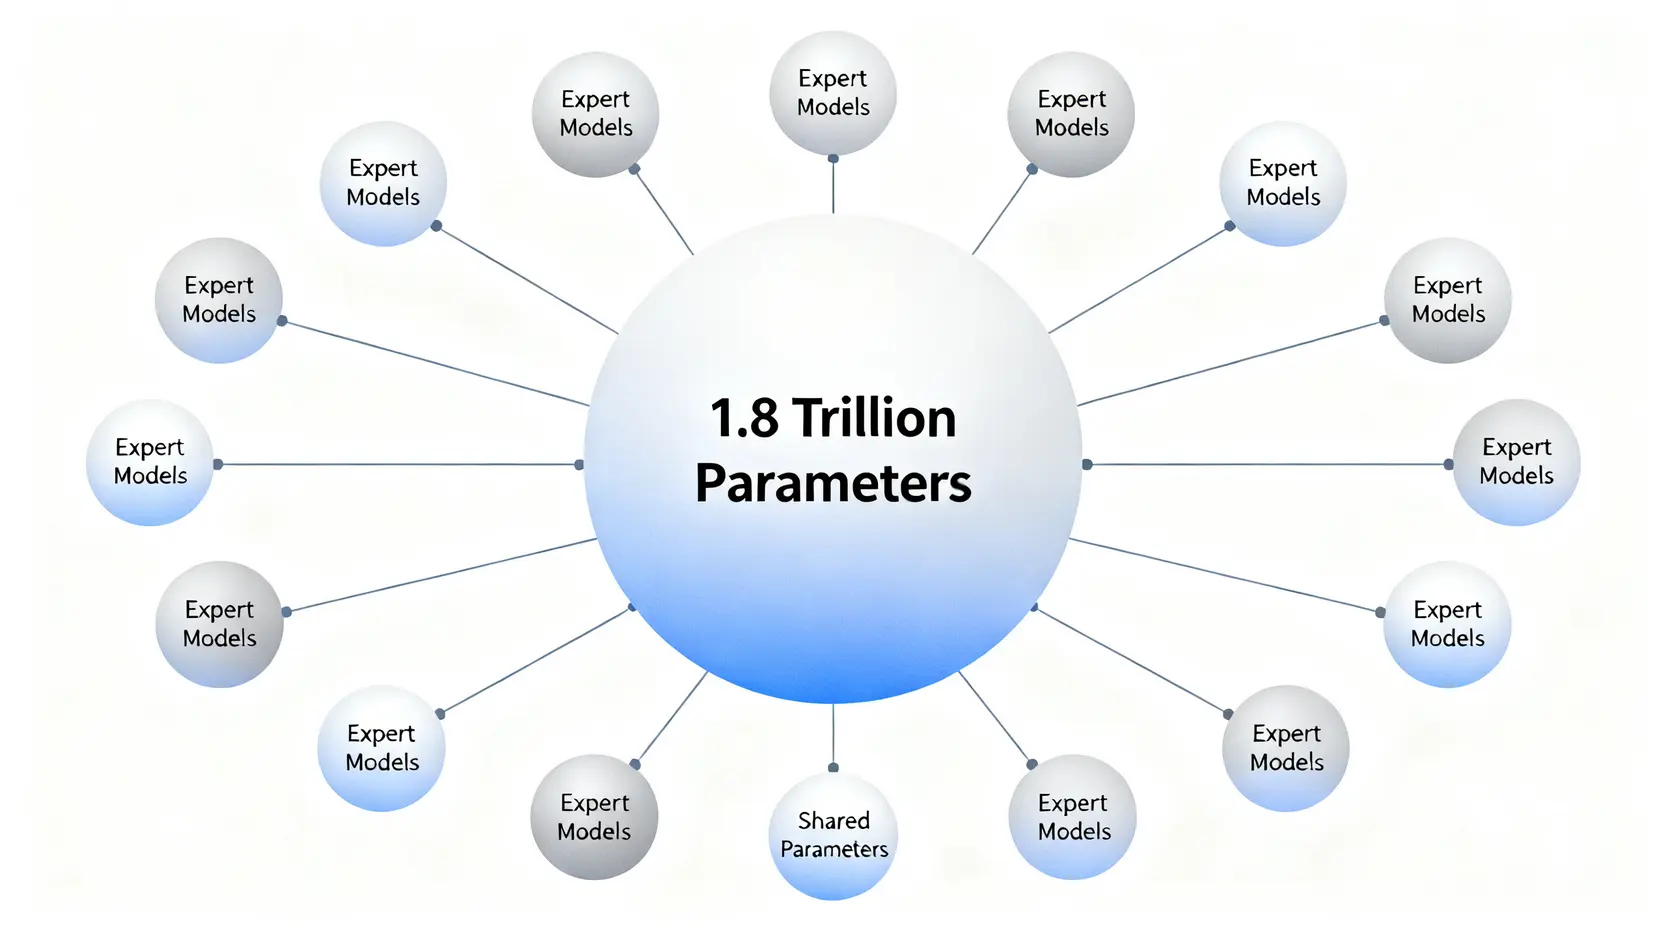
根据知名半导体研究机构 SemiAnalysis 的深度行业报告,GPT-4的总参数量大约为1.8万亿(1.8 Trillion)。这个数字在随后的一些学术论文(包括微软关于下一代数据中心设计的技术讨论)中得到了侧面证实。
这1.8万亿的参数是如何构成的呢?爆料显示,GPT-4采用了多专家组合的设计。它包含16个独立的专家模型,每个专家模型拥有大约1110亿(111B)个多层感知机(MLP)参数。此外,整个模型还共享了大约550亿个注意力机制(Attention)参数。
我们将这些数据做一个简单的数学计算:16个专家模型乘以1110亿,再加上550亿的共享参数,得出的总数正好在1.8万亿左右。这就是GPT-4庞大身躯的真实底细。
为什么OpenAI要对GPT-4的参数量保持绝对机密
OpenAI选择隐瞒参数量,主要是出于商业竞争与技术防壁的考虑。在开源模型(如Llama系列)步步紧逼的背景下,公开详细的架构参数无异于给竞争对手提供了一份现成的设计图纸。
此外,1.8万亿参数的超大规模,在训练和维护上都需要天文数字般的算力支持。保持机密性可以隐藏其高昂的算力成本,从而在商业谈判和估值中占据主动地位。
算力成本与训练投入的惊人数字
训练一个拥有1.8万亿参数的巨无霸模型,其背后的代价超乎想象。据业内估算,GPT-4的训练大约使用了2.5万张NVIDIA A100显卡,持续运行了数月之久。仅电费和硬件折旧成本就高达数千万美元。这种级别的研发投入,直接拉高了顶尖AI准入的门槛。
深入剖析混合专家模型架构的技术原理与运作逻辑
如果GPT-4是一个传统的“单体模型”(Dense Model),那么每次用户输入一个字,服务器都需要把全部1.8万亿个参数都运行一遍。这在物理规律和商业成本上几乎是不可行的。为了解决这个问题,OpenAI引入了混合专家模型架构(Mixture of Experts,简称 MoE)。
从单体模型到MoE:用“医院分科”通俗理解架构升级
我们可以把传统的单体模型比作一家只有一个医生的全科诊所。不管病人是来看感冒、看牙齿还是骨折,这个医生都得从头到尾亲自诊断。当病人数量暴增时,医生就会疲惫不堪,诊疗效率极低。
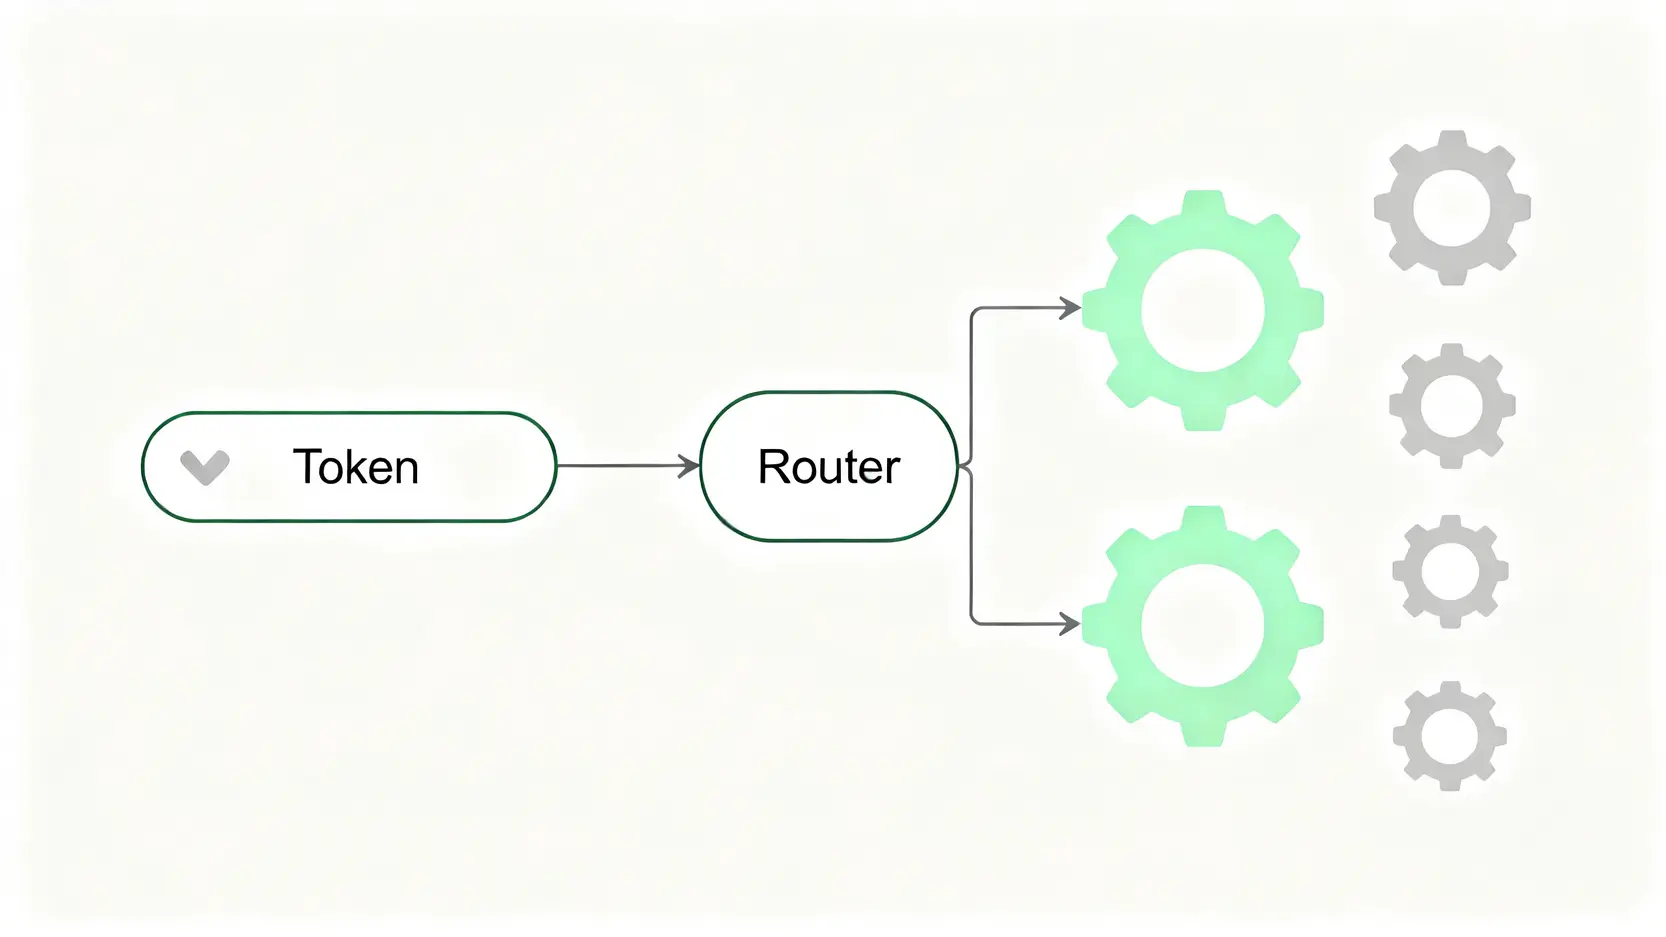
而混合专家模型架构则像是一家大型三甲医院。医院里设有内科、外科、眼科、骨科等16个不同的专家科室(即16个专家模型)。当病人(输入的Token)进入医院时,预检分诊台(路由器/Router)会迅速做出判断,将病人指引到最合适的两个科室去就诊。这样一来,其他14个科室的医生就可以继续休息或接待其他病人。
这种分工协作的机制,让大模型在拥有极高“总智商”的同时,避免了算力的无谓浪费。
路由算法(Router)的工作机制
在MoE架构中,最核心的控制枢纽就是路由算法(Gating Network)。它的任务是为每一个输入的词(Token)分配最合适的专家模型。GPT-4采用的是“Top-2路由”策略。
这意味着,对于输入的每个Token,路由器会评估16个专家的匹配度,最终只挑选匹配得分最高的2个专家来处理。通过这种实时的动态分发,模型在保证高精度的同时,极大地降低了单次计算的延迟。
如何评估大模型每次运行时的实际激活参数量?
了解了MoE的运作机制后,我们就可以解答一个关键问题:GPT-4在处理我们输入的日常对话时,实际动用了多少算力?这就涉及到了激活参数量的概念。
Token前向传播中的参数唤醒:280B的计算真相
虽然GPT-4的总参数量高达1.8万亿,但在实际运行(前向传播)时,由于采用了Top-2路由,每次只有2个专家模型会被激活。每个专家模型拥有1110亿参数,两个合起来就是2220亿参数。再加上始终保持唤醒状态的550亿共享参数,GPT-4在处理每个Token时的实际激活参数量大约是2800亿(280B)。
计算公式如下:
激活参数量 = 2 × 专家参数量 (111B) + 共享参数量 (55B) ≈ 2800亿 (280B)
这意味着,在用户端看来,GPT-4的响应速度和计算开销仅仅相当于一个2800亿参数的中型模型,但我们得到的回答质量,却是基于1.8万亿参数海量知识库过滤出来的。这种“以小博大”的工程设计,正是GPT-4大获成功的关键技术诀窍。
推理吞吐量与显存开销的权衡
天下没有免费的午餐,MoE架构虽然省下了计算量,却对硬件提出了极高的显存要求。因为这1.8万亿的参数必须全部加载到GPU的显存中,处于“随时待命”的状态。这就需要极其昂贵的显卡集群才能跑得动GPT-4,对于部署和日常托管来说,显存带宽 and 容量成了最大的瓶颈。
升级版对比:GPT-4与GPT-3.5、GPT-4o的代际参数效率
随着技术的快速演进,大模型的设计理念也在发生变化。从单体到MoE,再到如今更加注重多模态原生和推理效率的设计,我们可以通过对比来看清这一脉络。
经典模型参数效率与多模态优化的演变
在GPT-4之前,GPT-3是一个典型的单体大模型,拥有1750亿参数。每次向它提问,1750亿参数都会被全部激活。虽然这在当时已经是技术巅峰,但算力效率极低。
而GPT-4o(GPT-4 Omni)则是新一代的多模态旗舰模型。尽管OpenAI没有公开GPT-4o的具体参数,但行业内普遍认为,GPT-4o在参数规模上比GPT-4更加精简,甚至可能采用了更高效的单体或中型MoE设计。GPT-4o的核心突破在于“端到端多模态”,它将文本、语音、视觉无缝整合在同一个网络中,使得推理速度大幅提升,算力成本显著下降。
| 模型名称 | 架构类型 | 总参数量 | 每次激活参数量 | 核心技术特点 |
|---|---|---|---|---|
| GPT-3 | 单体模型 (Dense) | 1750亿 (175B) | 1750亿 (175B) | 开创了大模型预训练的先河 |
| GPT-4 | 混合专家架构 (MoE) | 约1.8万亿 (1.8T) | 约2800亿 (280B) | 强大的逻辑推理与多专家协作 |
| GPT-4o | 原生多模态一体化 | 未公开 (估算较GPT-4小) | 高效优化版 | 极速语音响应与极佳的性价比 |
到了2026年,大模型的技术发展已经不再盲目追求物理参数量上的“大”,而是更加看重“参数效率”以及在特定任务下的响应速度与能耗比。通过算法蒸馏和模型剪枝,新一代大模型正在以更小的体积提供媲美甚至超越GPT-4的智能表现。
总结:从参数竞争到架构创新的启示
从GPT-3的单体1750亿参数,到GPT-4的1.8万亿混合专家模型架构,AI技术的演进从来都不是简单的数据堆砌,而是极致的工程化突破。通过16个专家模型与高精度路由算法的协同工作,GPT-4实现了智能极限与商业成本之间的精妙平衡。
当我们探究“GPT 4 有多少个参数”时,我们看到的不仅仅是一个庞大的数字,更是整个人工智能行业走向精细化分工、注重参数效能的技术缩影。在算力资源依然珍贵的今天,如何用更低的激活参数量换取更高的智能表现,依然是各大科技巨头不断探索的终极课题。
常见问题解答
GPT-4 的 1.8 万亿参数得到 OpenAI 官方承认了吗?
没有。OpenAI官方为了保持商业竞争优势以及防范技术逆向工程,始终拒绝透露GPT-4的具体参数量。目前的1.8万亿(1.8T)参数数据主要来源于半导体研究机构SemiAnalysis的爆料以及微软等合作伙伴学术论文中的侧面印证,在业内已被广为接受。
什么是 MoE 混合专家模型架构?它与传统的单体模型有什么区别?
MoE是一种将大任务分发给不同专业子网络处理的架构。在传统的单体模型中,无论问题多简单,所有参数都必须参与计算。而在MoE架构中,模型被划分为多个“专家”,通过路由算法,每次只调用与问题最相关的少数几个专家,从而在保障海量知识储备的同时,大幅降低计算开销。
为什么 GPT-4o 的参数量反而可能比 GPT-4 小?
这是因为AI行业的技术演进方向已经从“单纯堆砌参数”转变为“追求参数效率与多模态原生”。GPT-4o通过算法优化、模型蒸馏以及文本、视觉、音频一体化训练,用更紧凑的架构实现了极快的响应速度和更低的算力成本,更符合大规模商业落地应用的需求。
在MoE架构中,如果路由器将任务分发给了错误的专家会怎么样?
如果路由算法分发错误,大模型就可能会给出文不对题或者逻辑混乱的回答,这也就是常说的“AI幻觉”表现之一。因此,设计高精度的路由权重分配算法以及防止专家模型出现过载或闲置,是MoE架构训练过程中的一大技术难点。